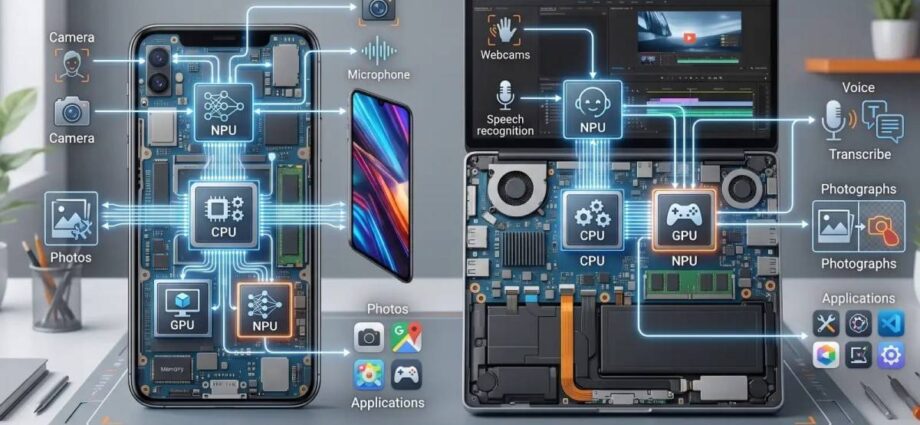
La inteligencia artificial está dejando de depender exclusivamente de servidores remotos. Los procesadores de los teléfonos inteligentes incorporan unidades especializadas capaces de ejecutar determinadas operaciones de aprendizaje automático directamente en el dispositivo. Las NPU, diseñadas para acelerar redes neuronales, están modificando la arquitectura de los chips móviles y haciendo posible que funciones que antes requerían una conexión constante a la nube puedan ejecutarse localmente.
Durante años, un teléfono inteligente podía utilizar su procesador central para realizar prácticamente cualquier tarea computacional. Cuando una aplicación necesitaba una operación compleja de inteligencia artificial, una alternativa frecuente consistía en enviar los datos a un servidor, procesarlos en centros de datos y devolver el resultado al dispositivo.
Ese modelo continúa siendo fundamental para aplicaciones que requieren grandes cantidades de procesamiento. Sin embargo, presenta inconvenientes. La comunicación con un servidor introduce latencia, requiere conectividad y supone transferir información que, en determinados casos, puede ser sensible. Además, mantener una conexión permanente puede incrementar el consumo energético.
La respuesta de la industria ha sido incorporar nuevos bloques especializados dentro del propio sistema en chip, o SoC. Entre ellos se encuentran las Neural Processing Units, conocidas como NPU, aunque cada fabricante utiliza denominaciones y arquitecturas diferentes. Apple emplea el nombre Neural Engine; otros fabricantes utilizan términos como AI Engine o NPU.
Su principio de funcionamiento es relativamente sencillo de explicar. Una red neuronal realiza enormes cantidades de operaciones matemáticas, particularmente multiplicaciones y acumulaciones sobre grandes conjuntos de datos. Una unidad especializada puede ejecutar estas operaciones de manera paralela y con una arquitectura adaptada a los patrones de cálculo característicos del aprendizaje automático.
La diferencia con una CPU es importante. El procesador central está diseñado para ejecutar una amplia variedad de instrucciones y atender tareas generales del sistema. Una GPU, por su parte, destaca en operaciones paralelas y tiene una función fundamental en gráficos, aunque también resulta muy útil para inteligencia artificial. La NPU está específicamente orientada a determinadas cargas de trabajo de aprendizaje automático.
Esto no significa que la NPU sustituya a la CPU o a la GPU. La tendencia actual es precisamente la contraria: los fabricantes construyen arquitecturas heterogéneas en las que cada unidad realiza las operaciones para las que resulta más adecuada. Una aplicación puede utilizar la CPU para controlar la lógica general, la GPU para determinadas operaciones paralelas y la NPU para ejecutar inferencias de redes neuronales.
El beneficio más visible para el usuario es la posibilidad de ejecutar modelos de inteligencia artificial directamente en el teléfono. Reconocimiento de voz, traducción, procesamiento de imágenes, eliminación de ruido, clasificación de fotografías, generación de determinados contenidos y otras funciones pueden utilizar modelos locales cuando el hardware y el software lo permiten.
La ejecución local también puede reducir la latencia. Si una operación no necesita enviar información a un servidor y esperar su respuesta, el resultado puede producirse directamente en el dispositivo. En determinadas funciones interactivas, esos milisegundos importan: una cámara que procesa una imagen, un sistema que identifica una voz o una aplicación que analiza información en tiempo real pueden beneficiarse de esa proximidad.
La eficiencia energética constituye otra pieza fundamental. Una NPU no hace que cualquier tarea consuma menos energía automáticamente. Su ventaja aparece cuando una carga de inteligencia artificial puede ejecutarse de manera más eficiente en el acelerador especializado que utilizando recursos generales del procesador. El objetivo es obtener más operaciones útiles por unidad de energía.
Las arquitecturas recientes muestran hasta dónde está llegando esta integración. Apple, por ejemplo, ha incorporado Neural Engine junto con aceleradores neuronales en sus CPU y GPU, formando un sistema de cómputo heterogéneo para cargas de inteligencia artificial. En generaciones recientes, la compañía también ha incrementado la capacidad de procesamiento local y la memoria disponible para ejecutar modelos directamente en sus dispositivos.
El cambio tiene además una dimensión relacionada con la privacidad. Cuando una función puede ejecutarse completamente en el dispositivo, determinados datos no necesitan abandonar el teléfono. Esto no significa que toda la inteligencia artificial local sea automáticamente privada o segura; el comportamiento depende del diseño de cada aplicación y de los datos que ésta decida enviar a servidores externos. Pero el procesamiento local ofrece una arquitectura que puede reducir esa dependencia.
El desafío está en el tamaño de los modelos. Los sistemas de inteligencia artificial más sofisticados pueden requerir grandes cantidades de memoria y capacidad de cálculo. Un teléfono tiene restricciones térmicas, energéticas y físicas que no existen de la misma manera en un centro de datos. Por ello, la IA móvil depende también de técnicas como cuantización, compresión, reducción de precisión y diseño de modelos más pequeños.
La memoria adquiere así una importancia comparable a la capacidad de cálculo. No basta con disponer de una NPU rápida si el sistema no puede alimentar suficientemente rápido al acelerador con los datos que necesita. Por esta razón, los fabricantes están trabajando simultáneamente en aceleradores, controladores de memoria, ancho de banda y arquitecturas de memoria compartida.
El resultado es una transformación silenciosa de los teléfonos inteligentes. El dispositivo deja de ser únicamente una terminal conectada a servicios de inteligencia artificial y comienza a convertirse en una plataforma capaz de ejecutar parte de esos modelos por sí misma.
La NPU representa, en ese sentido, algo más que un nuevo componente del procesador. Forma parte de un cambio arquitectónico en el que CPU, GPU, aceleradores neuronales, memoria y software trabajan conjuntamente para decidir dónde y cómo ejecutar cada operación. La inteligencia artificial móvil no consiste solamente en incorporar modelos más grandes, sino en hacerlos funcionar dentro de las restricciones de un dispositivo que cabe en la mano.
Durante los próximos años, esa distribución del procesamiento probablemente será uno de los elementos menos visibles y más importantes de la evolución de los teléfonos inteligentes. Cuando una traducción aparezca instantáneamente, una fotografía sea procesada sin conexión o una función de voz responda sin enviar continuamente el audio a la nube, buena parte de ese trabajo ocurrirá en un componente que el usuario probablemente nunca verá: la unidad de procesamiento neuronal.