Los avances en procesadores especializados están trasladando cada vez más tareas de inteligencia artificial hacia teléfonos y otros dispositivos, aunque la ejecución local de modelos de lenguaje y la computación neuromórfica son tecnologías relacionadas pero todavía no equivalentes.
La inteligencia artificial está entrando en una nueva etapa de procesamiento. Durante años, muchas aplicaciones dependieron de centros de datos para ejecutar modelos complejos y devolver sus resultados a teléfonos, computadoras y otros dispositivos. Ahora, los fabricantes están incorporando unidades especializadas capaces de realizar una parte creciente de esas operaciones directamente en el equipo del usuario.
El cambio responde a tres problemas concretos: latencia, consumo energético y privacidad. Cuando una tarea puede ejecutarse localmente, los datos no necesariamente tienen que viajar hasta un servidor remoto, la respuesta puede producirse con mayor rapidez y disminuye la cantidad de información que debe transmitirse por una red.
En los teléfonos actuales, esta función suele recaer principalmente en las llamadas NPU, o unidades de procesamiento neuronal. Estos aceleradores están diseñados para ejecutar operaciones matemáticas habituales en las redes neuronales, especialmente multiplicaciones de matrices y otros cálculos paralelos utilizados por los modelos de inteligencia artificial.
La computación neuromórfica representa una aproximación diferente. Su objetivo es inspirarse en determinadas características del funcionamiento del cerebro para construir sistemas en los que procesamiento, memoria y comunicación puedan organizarse de manera más eficiente. Algunos diseños utilizan redes neuronales de impulsos, conocidas como spiking neural networks, que procesan información mediante eventos en lugar de mantener una actividad constante.
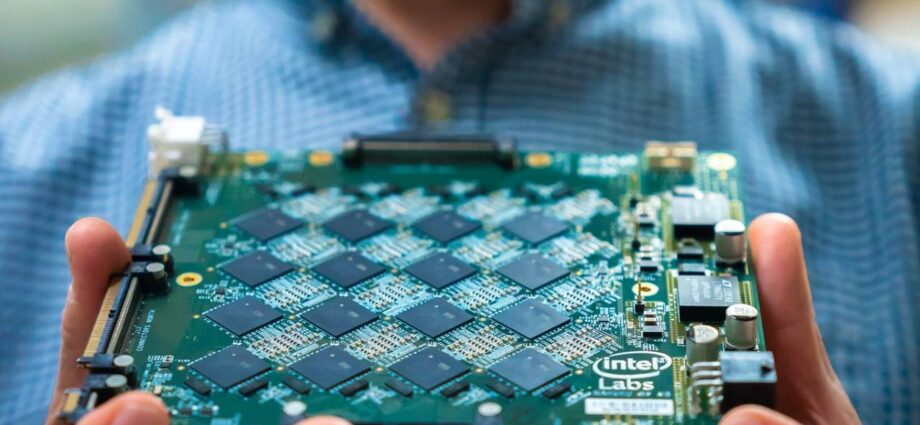
Intel, por ejemplo, desarrolla la familia Loihi, cuyos procesadores neuromórficos utilizan computación basada en eventos y buscan reducir el movimiento de datos y el consumo energético. IBM también ha desarrollado arquitecturas inspiradas en principios neuromórficos, aunque su procesador NorthPole no intenta reproducir literalmente las neuronas biológicas: utiliza una arquitectura distribuida con memoria integrada y procesamiento altamente paralelo.
La diferencia es importante porque buena parte de la IA que actualmente llega a los teléfonos no se ejecuta en chips neuromórficos. Los dispositivos comerciales utilizan principalmente CPU, GPU y NPU convencionales diseñadas específicamente para acelerar inteligencia artificial. La computación neuromórfica continúa teniendo una presencia mayoritaria en investigación y en aplicaciones especializadas.
Eso no significa que la idea neuromórfica sea irrelevante para los dispositivos móviles. Una de sus principales promesas es reducir el movimiento de información entre memoria y procesador. En los sistemas tradicionales, trasladar grandes cantidades de datos puede consumir una parte considerable de la energía. Mantener más información cerca de las unidades de cálculo puede disminuir ese costo.
IBM demostró esta estrategia con NorthPole, un prototipo de procesador de inferencia que integra 256 núcleos y 192 megabytes de memoria SRAM distribuida en el propio chip. En pruebas de visión artificial realizadas por IBM, la arquitectura mostró una eficiencia energética muy superior a determinadas CPU y GPU utilizadas como referencia. Los resultados corresponden a tareas específicas y no significan que el procesador sea universalmente más eficiente para cualquier aplicación de inteligencia artificial.
La industria móvil está siguiendo una dirección parcialmente paralela. Qualcomm, por ejemplo, ha diseñado sus plataformas Snapdragon para ejecutar modelos generativos directamente en el dispositivo mediante su arquitectura de inteligencia artificial y sus NPU Hexagon. En 2026, la compañía ha presentado una nueva generación de esta arquitectura orientada específicamente a modelos generativos y agentes capaces de realizar tareas de manera local.
Una de las dificultades para ejecutar modelos de lenguaje grandes en un teléfono es precisamente su tamaño. Un modelo con miles de millones de parámetros requiere memoria y capacidad de cálculo considerables. Por ello, la IA local utiliza técnicas como cuantización, compresión, optimización de modelos y arquitecturas de tipo Mixture of Experts, en las que no todos los parámetros tienen que activarse para cada token generado.
Qualcomm señala que sus plataformas móviles de 2026 pueden ejecutar modelos de lenguaje directamente en el dispositivo y que su nueva arquitectura Hexagon está preparada para modelos de tipo Mixture of Experts. En determinadas configuraciones, un modelo puede mantener disponibles decenas de miles de millones de parámetros y activar solamente una fracción durante cada paso de generación.
Esto cambia la relación entre el tamaño del modelo y el dispositivo. Ya no es indispensable que un teléfono ejecute permanentemente un modelo gigantesco de manera completa. Puede seleccionar modelos especializados según la tarea, utilizar diferentes niveles de precisión numérica y repartir el trabajo entre CPU, GPU y NPU.
La privacidad es otra de las razones para trasladar determinadas funciones al dispositivo. Un asistente que procesa localmente una fotografía, una nota personal o una instrucción de voz puede reducir la necesidad de enviar esos datos a servidores externos. Sin embargo, “IA local” no equivale automáticamente a privacidad absoluta: una aplicación puede combinar procesamiento en el dispositivo con servicios en la nube, y la protección final depende también del sistema operativo, las aplicaciones y las políticas de tratamiento de datos.
El procesamiento local también puede reducir la latencia. Una consulta que no necesita viajar hasta un centro de datos y regresar puede comenzar a procesarse inmediatamente en el teléfono. Esta característica resulta especialmente útil para funciones que necesitan respuestas continuas, como traducción, reconocimiento de voz, análisis de imágenes, asistentes personales y determinadas aplicaciones de realidad aumentada.
El consumo energético constituye quizá el desafío más complejo. Ejecutar inteligencia artificial de manera permanente puede agotar rápidamente una batería si el hardware no está optimizado. Por eso, las arquitecturas actuales buscan utilizar el procesador adecuado para cada carga de trabajo. Las tareas pequeñas pueden ejecutarse en núcleos de bajo consumo, mientras que las operaciones intensivas se distribuyen entre aceleradores especializados.
La computación neuromórfica intenta llevar esa eficiencia todavía más lejos mediante procesamiento disperso y activado por eventos. Intel explica que Loihi 2 está diseñado precisamente para minimizar la actividad y el movimiento de datos, mientras que IBM ha explorado arquitecturas en las que la memoria se encuentra mucho más cerca de las unidades de procesamiento.
Sin embargo, existen obstáculos importantes antes de imaginar un teléfono capaz de ejecutar cualquier modelo de lenguaje avanzado sin conexión. La memoria disponible, la disipación térmica, el consumo energético y la velocidad de procesamiento continúan imponiendo límites. Además, los modelos más grandes siguen beneficiándose de la infraestructura de centros de datos.
Por eso, el futuro inmediato probablemente no será completamente local ni completamente dependiente de la nube. Una arquitectura híbrida resulta más realista: el teléfono puede resolver localmente tareas relacionadas con información personal, respuestas rápidas y funciones que requieren baja latencia, mientras que un servidor remoto se utiliza para consultas que demandan modelos mucho más grandes o capacidad de cálculo adicional.
La evolución también plantea una cuestión de diseño. El objetivo ya no consiste únicamente en fabricar procesadores más rápidos, sino en reducir la cantidad de energía y movimiento de datos necesarios para producir cada resultado. En ese contexto, las NPU móviles, las arquitecturas de memoria cercana al procesamiento y la investigación neuromórfica forman parte de una misma transformación hacia una inteligencia artificial más próxima al usuario.
La verdadera transición, por tanto, no consiste simplemente en introducir “un cerebro artificial” dentro del teléfono. Consiste en rediseñar la relación entre modelo, memoria, procesador y datos para que determinadas capacidades de IA puedan funcionar de manera rápida, eficiente y, cuando el diseño lo permita, sin abandonar el dispositivo.
Los procesadores neuromórficos todavía no han sustituido a las arquitecturas convencionales en los teléfonos inteligentes, pero sus principios —procesamiento eficiente, actividad dispersa y reducción del movimiento de datos— coinciden con algunos de los problemas que la industria móvil necesita resolver. La carrera por llevar más inteligencia al dispositivo apenas comienza, y su resultado dependerá tanto de los avances en hardware como de la capacidad de los desarrolladores para crear modelos suficientemente pequeños y eficientes.